AI ENGINEERING — Projet indépendant
AI-Powered Peacebuilding Knowledge Assistant (RAG)
Contexte
En République centrafricaine, les informations utiles aux acteurs engagés dans la consolidation de la paix sont dispersées dans des rapports d’ONG, des publications des Nations unies et de la MINUSCA, ainsi que dans des documents issus de processus de dialogue, notamment le Forum national de Bangui de 2015. Le projet vise à rendre ce corpus plus facilement interrogeable tout en conservant la traçabilité des informations utilisées pour générer chaque réponse.
Résumé
Assistant documentaire multilingue (FR/EN) conçu pour rechercher des informations dans un corpus documentaire complexe et produire des réponses fondées sur les sources, accompagnées de citations vérifiables.
Contributions
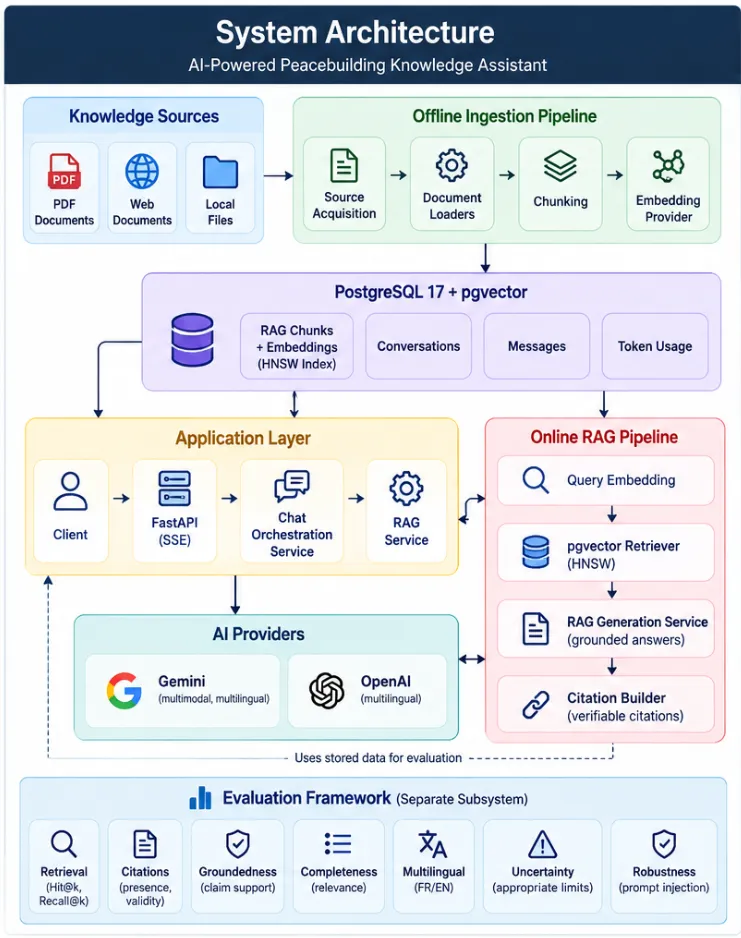
- RAG & AI Engineering : Conception du pipeline RAG : ingestion documentaire, embeddings, retrieval PostgreSQL/pgvector avec index HNSW, génération fondée sur les sources avec Gemini/OpenAI, gestion de l’incertitude et citations structurées.
- Backend & Data : API asynchrone FastAPI/Pydantic avec streaming SSE, persistance des conversations et de l’usage des modèles, SQLAlchemy async, PostgreSQL et migrations Alembic.
- Évaluation & robustesse : Benchmarks du retrieval (Hit@K, Recall@K, MRR), fidélité aux sources, citations, complétude/pertinence, cohérence FR/EN, incertitude et scénarios adversariaux d’injection de prompt.
- Production Engineering : Architecture modulaire indépendante du fournisseur LLM, configuration sécurisée, logging, health/readiness checks, Docker, Ruff et 611 tests unitaires et d’intégration validés depuis un clone propre.
Résultats
- Retrieval : Hit@20 : 100 % · Recall@20 : 100 % · MRR@20 : 0,798 sur 9 cas answerables du benchmark.
- Fidélité aux sources : 85,7 % de précision sur le support des affirmations sur 7 cas ; 100 % de correspondance exacte de la source de support.
- Complétude & pertinence : 94,4 % de couverture moyenne des concepts attendus et 100 % de réponses jugées pertinentes sur 9 cas.
- Citations : 100 % de présence des citations et 100 % de citations structurellement valides sur le benchmark dédié.
- FR/EN : Recall des sources attendues : 100 % en français et 100 % en anglais sur les cas multilingues évalués.
- Qualité logicielle : 611 tests automatisés validés avec Ruff, migrations, démarrage FastAPI, connectivité PostgreSQL et health/readiness également vérifiés depuis un clone propre.
Plus-value
- Information vérifiable : Les réponses conservent un lien explicite avec les passages documentaires récupérés afin de permettre la vérification des sources.
- Qualité mesurable : L’évaluation sépare retrieval, génération, citations, multilingue, incertitude et robustesse afin d’identifier précisément les régressions et les axes d’amélioration.
- Architecture évolutive : Le découplage entre ingestion, embeddings, retrieval, génération et fournisseurs LLM permet de faire évoluer chaque composant sans réécrire l’ensemble du système.
Stack technique
Python · FastAPI · Pydantic · PostgreSQL · pgvector · Gemini/OpenAI · Docker · Alembic · pytest · Ruff
Évaluation du système
L’évaluation distingue la qualité du retrieval de celle de la génération. Hit@K, Recall@K et MRR mesurent la récupération des sources ; des évaluations distinctes couvrent la fidélité aux passages récupérés, la validité des citations, la complétude et la pertinence, la gestion de l’incertitude et la cohérence FR/EN. Ces benchmarks utilisent de petits jeux de cas ciblés afin de détecter les régressions et valider l’architecture ; ils ne constituent pas une garantie de performance générale.
Industrialisation
Configuration par environnement, migrations Alembic, journalisation des erreurs aux frontières du système, endpoints distincts de liveness et readiness, conteneurisation Docker et validation depuis un clone propre. L’image API a été réduite d’environ 1,16 Go à 559 Mo en excluant les dépendances et artefacts de développement du runtime.