CLOUD & DATA — Projet indépendant
Data Lakehouse Cloud
Contexte
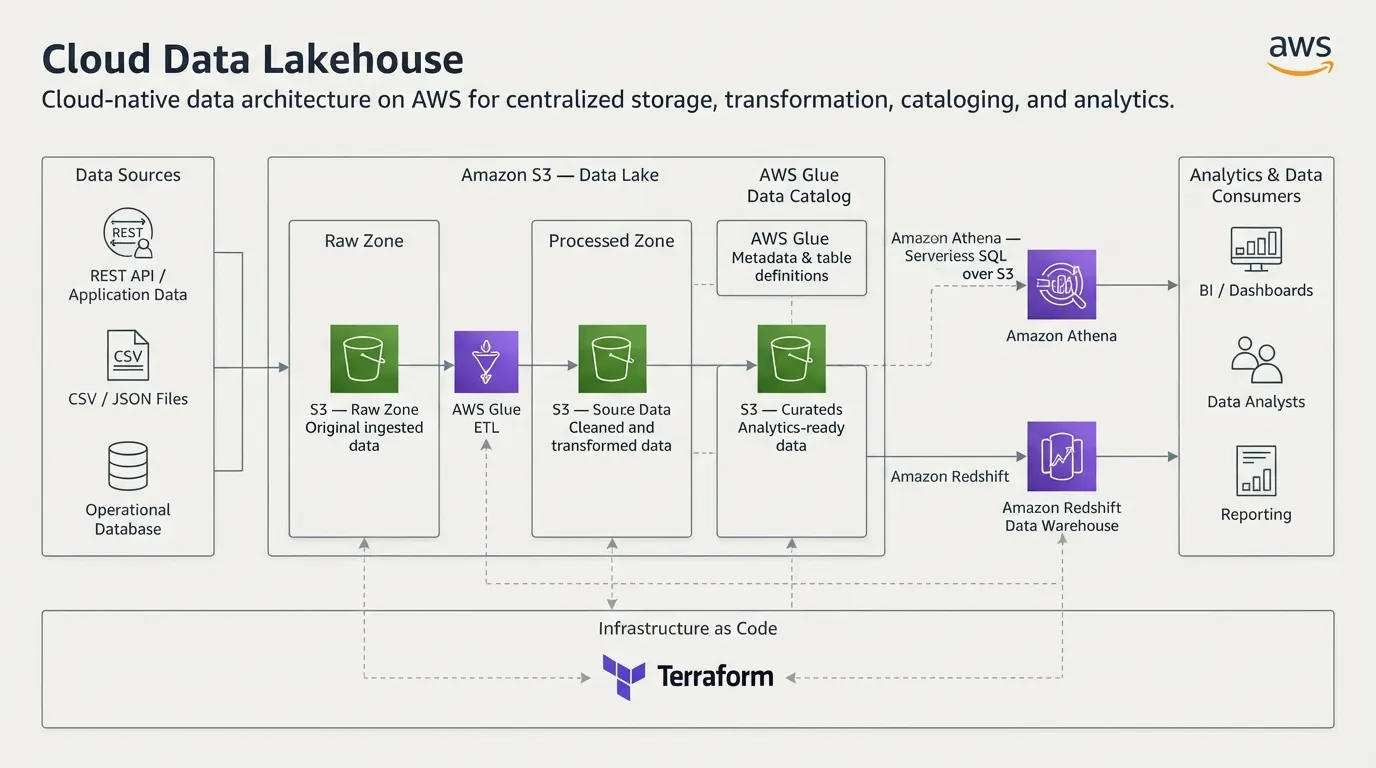
Lorsque les données proviennent de plusieurs systèmes, les réunir dans un même espace de stockage ne suffit pas à les rendre utilisables. Les équipes doivent aussi connaître leur structure, retrouver les jeux de données disponibles et disposer d’un moyen de les transformer sans multiplier les copies et les traitements isolés. Ce projet explore une architecture AWS capable de relier stockage, catalogue et analyse au sein d’une plateforme cohérente.
Résumé
Conception d’un Data Lakehouse sur AWS pour centraliser des données de sources multiples, organiser leur transformation et les rendre accessibles à des usages analytiques.
Contributions
- Stockage et transformation : Organisation des données dans Amazon S3 et mise en place de pipelines ETL avec AWS Glue.
- Découverte et analyse : Catalogage des jeux de données, interrogation du Data Lake avec Amazon Athena et intégration d’Amazon Redshift pour les analyses nécessitant une couche Data Warehouse.
- Infrastructure : Définition et automatisation des ressources AWS avec Terraform afin de pouvoir reproduire l’architecture.
Résultats
- Parcours de données intégré : Architecture réunissant stockage, transformation, catalogage et analyse dans un même parcours de données.
- Deux modes d’analyse : Interrogation des données du lac avec Athena et couche Data Warehouse avec Redshift.
- Infrastructure en code : Ressources décrites sous forme de code avec Terraform.
Plus-value
- Données plus faciles à retrouver : Le catalogue rend les jeux de données et leur structure identifiables.
- Usages analytiques distincts : Athena et Redshift offrent des accès adaptés à différents besoins d’analyse.
- Architecture reproductible : Terraform formalise les ressources nécessaires et facilite leur redéploiement.
Stack technique
AWS · Amazon S3 · AWS Glue · AWS Glue Data Catalog · Amazon Athena · Amazon Redshift · Terraform