Data Engineering
Concevoir des plateformes de données fiables et des pipelines scalables qui transforment la donnée brute en actifs prêts pour la production.
Je conçois et développe des solutions Data et IA fiables : architecture et traitement des données, entraînement de modèles, développement d’APIs et déploiement en production.
Je combine Data Engineering, AI Engineering, ML/MLOps et Cloud & Software Engineering pour concevoir des systèmes fiables, intégrés et prêts pour la production.
Concevoir des plateformes de données fiables et des pipelines scalables qui transforment la donnée brute en actifs prêts pour la production.
Construire des systèmes d’IA orientés production en intégrant LLMs, données, APIs, recherche vectorielle et architectures RAG.
Industrialiser le cycle de vie des modèles ML, de l’entraînement et du suivi des expérimentations au déploiement, au monitoring et à l’automatisation.
Concevoir des services backend et des architectures cloud fiables pour intégrer, déployer et exploiter des systèmes Data & IA en production.
Data Engineering/AI Engineering/ML & MLOps/Cloud & Software Engineering
Une sélection de projets en Data Engineering, Machine Learning et AI Engineering, allant des plateformes de données temps réel aux systèmes RAG, MLOps, architectures cloud et solutions intelligentes basées sur la simulation et l’optimisation.

Conception et développement d’une plateforme de données en temps réel fondée sur une architecture distribuée d’event streaming. Les événements sont collectés, validés et traités en continu. Les données exploitables et les agrégations sont stockées dans un Data Lake compatible S3. Les événements invalides sont conservés séparément pour faciliter leur diagnostic.

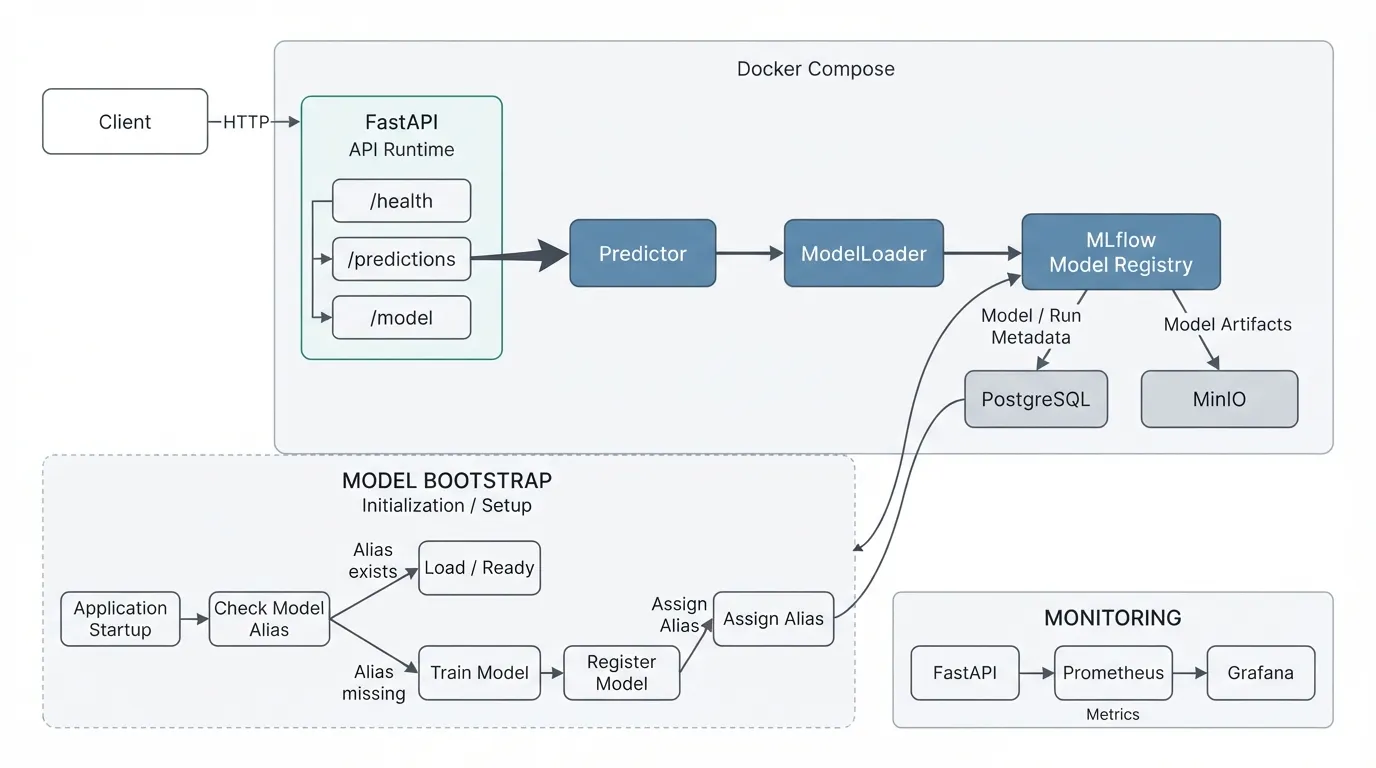
Plateforme MLOps couvrant la préparation des données, l’entraînement et l’évaluation d’un modèle, son enregistrement dans MLflow, son exposition par API et la supervision de son fonctionnement. Chaque prédiction indique la version du modèle utilisée. Les expériences et les métriques de service facilitent le suivi des modèles et l’activité de l’API.

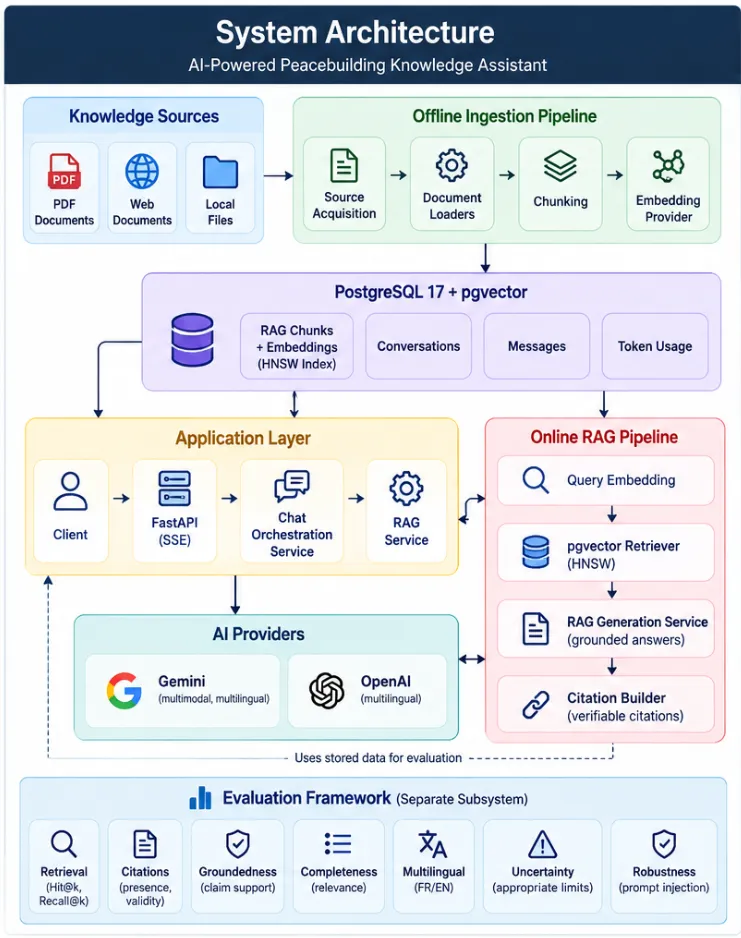
Assistant documentaire multilingue (FR/EN) conçu pour rechercher des informations dans un corpus documentaire complexe et produire des réponses fondées sur les sources, accompagnées de citations vérifiables.

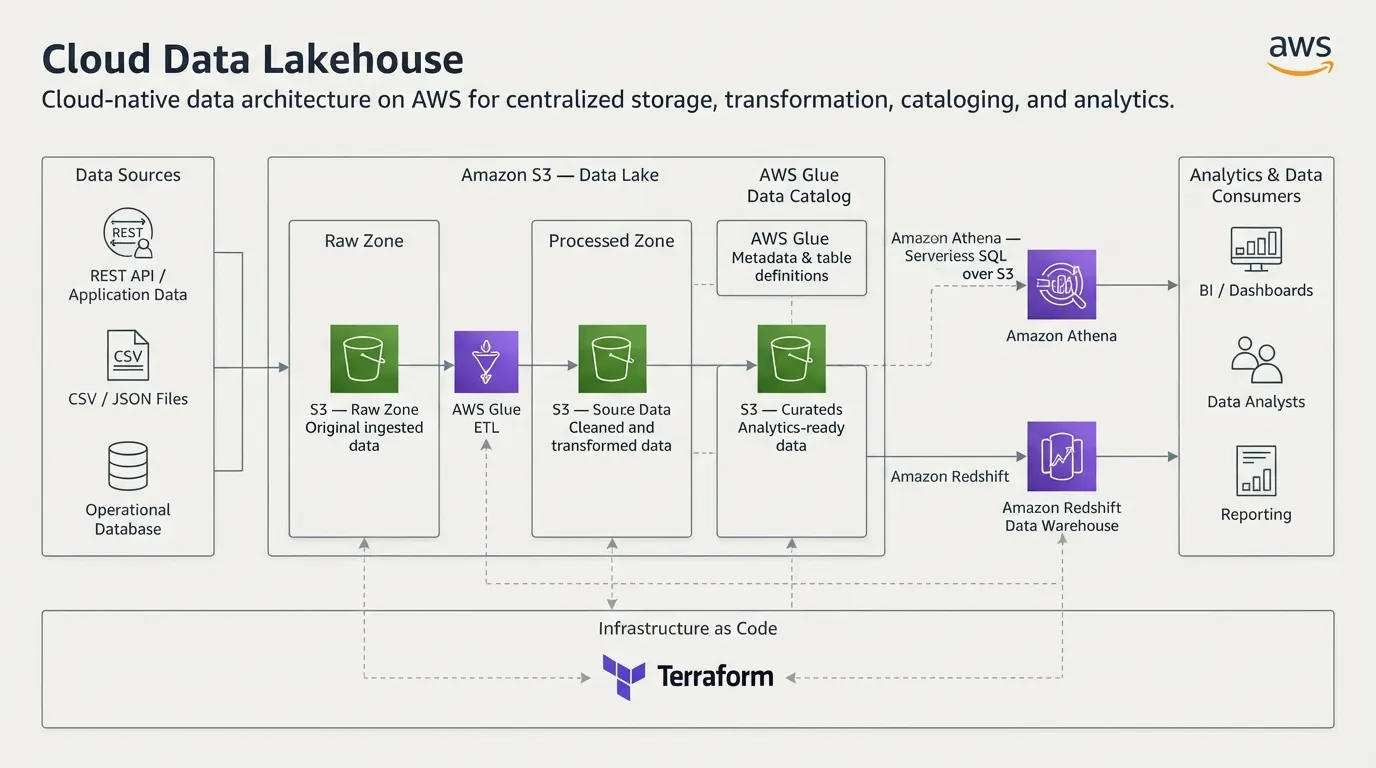
Conception d’un Data Lakehouse sur AWS pour centraliser des données de sources multiples, organiser leur transformation et les rendre accessibles à des usages analytiques.
Des plateformes Data et architectures cloud aux systèmes de Machine Learning, MLOps et applications d’IA basées sur les LLM et le RAG.
Un parcours combinant ingénierie des données, systèmes IA, machine learning, cloud et développement logiciel, avec une approche orientée vers la conception de solutions fiables et industrialisables.
Projet professionnel : conception et développement d’un assistant de connaissances RAG multilingue avec Python, FastAPI, PostgreSQL/pgvector, embeddings et APIs LLM : ingestion documentaire, recherche vectorielle, streaming SSE, citations vérifiables et évaluation du retrieval, de la groundedness, des citations et de la qualité des réponses.
Conception et développement de 6 applications web répondant à différents besoins métier, de l’analyse fonctionnelle à la mise en production : frontend/backend, APIs, bases de données, authentification, intégrations externes, tests, déploiement et maintenance.
Conception et développement d’une application de carte de visite digitale avec Next.js/React, TypeScript, Node.js/Fastify, Clerk, Supabase/PostgreSQL et Cloudinary. Développement d’analytics pour suivre vues, interactions et leads, avec restitution dans le dashboard et mise à jour temps réel via Server-Sent Events (SSE). Utilisation de services AWS au cours de l’évolution du projet : Amplify, API Gateway, VPC, DynamoDB, CloudFront, S3 et SES.
Conception de plateformes et pipelines batch et streaming avec Python/PySpark, Spark Structured Streaming, Kafka, Airflow et AWS : ingestion, traitements distribués, validation et qualité des données, Data Lake, Avro/Schema Registry, observabilité et CI/CD.
Développement et industrialisation de workflows ML couvrant préparation des données, entraînement, expérimentation, versionnement, serving et monitoring avec Scikit-learn, MLflow, FastAPI, Docker, PostgreSQL, Prometheus/Grafana, tests automatisés et CI/CD.
Analyse des besoins fonctionnels et métier afin de les traduire en solutions techniques adaptées, depuis la définition des flux de données et des fonctionnalités jusqu’aux choix d’architecture et à l’intégration des différents composants.
Développement de modèles de Machine Learning et de séries temporelles pour des cas d'usage industriels, notamment la prédiction des performances et des temps de recette de presses vibrantes.
Analyse et modélisation de données industrielles afin d'identifier les facteurs influençant les performances des équipements et de produire des modèles prédictifs.
Contribution à l'architecture data, aux choix technologiques ainsi qu'au développement d'interfaces de suivi et de visualisation.
Développement d'un PoC Data Science pour la plateforme SmartForest, consacré à l'analyse de données issues de systèmes industriels.
Application de méthodes statistiques et de Machine Learning pour la détection d'anomalies et la prévision à partir de données industrielles.
Exploration d'approches de maintenance prédictive visant à détecter plus tôt les comportements anormaux et les défaillances potentielles des équipements.
Réalisation de projets de modélisation statistique et prédictive appliqués à des problématiques de prévision des achats et de gestion des stocks.
Analyse de données historiques et modélisation d'événements afin d'identifier des tendances et des comportements d'achat.
Mise en œuvre d'approches de prévision destinées à améliorer l'anticipation des achats et l'optimisation des stocks.
Réalisation d'analyses statistiques et de travaux de prévision sur des données démographiques liées aux migrations, à la natalité et à la mortalité.
Contribution à l'analyse des tendances démographiques et à des travaux de projection de l'évolution de la population.
Participation à l'analyse statistique de données relatives à la qualité de l'air urbain.
Un parcours académique construit sur les statistiques, les probabilités et la modélisation, puis spécialisé en data science, machine learning et traitement de données complexes.
Formation avancée en statistique et modélisation, machine learning, deep learning et Big Data, complétée par les systèmes d'information, bases et entrepôts de données, Business Intelligence et traitement de données complexes.
Formation quantitative en statistiques, probabilités et mathématiques avancées, complétée par l'algorithmique, la programmation, les bases de données, la recherche opérationnelle, la biostatistique et l'analyse de données.
Badges de compétences couvrant les fondamentaux d’AWS, l’architecture, les réseaux, le serverless et la migration de données.
Une expertise multidisciplinaire combinant data engineering, AI engineering, machine learning, MLOps, cloud et développement logiciel.
Je combine expertise technique et approche d'ingénierie de bout en bout : concevoir des pipelines data fiables, développer des systèmes IA et ML, puis les intégrer et les déployer dans des environnements de production.
Conception d'architectures Data & IA, choix des composants, intégration et mise en production.
Ingestion batch et streaming, transformation, qualité des données, orchestration et plateformes analytiques.
RAG, systèmes LLM, recherche sémantique, évaluation et workflows agentiques.
Entraînement, expérimentation, versioning, serving, CI/CD, monitoring et gestion du cycle de vie des modèles.
Des fondations data aux systèmes intelligents en production
Vous avez un projet Data ou IA, un besoin d’industrialisation ou un défi technique à résoudre ? Échangeons sur la conception d’une solution fiable, scalable et prête pour la production.